OpenAI: generar texto
Usa OpenAI: generar texto para pedir a un modelo de OpenAI un texto corto a mitad del recorrido y luego reutilízalo en un push, correo electrónico o SMS posterior. Este punto se autentica con su propia clave de API de OpenAI. No utiliza ninguna integración a nivel de cuenta configurada en otra parte en Ajustes.
Usos típicos:
- Personalizar una línea de mensaje: redacta un gancho de una línea a partir de las etiquetas de un viajero y luego insértalo en el siguiente push o correo electrónico con Contenido dinámico.
- Resumir antes de enviar: convierte algunas etiquetas, como el último pedido o la categoría de navegación, en una línea corta en lenguaje natural que una plantilla pueda mostrar.
- Variar la redacción: pide una redacción ligeramente diferente en cada ejecución para que los viajeros no vean un texto idéntico cada vez que pasen por ahí.
Configurar el punto
Anchor link to- Arrastra OpenAI: generar texto desde la sección Integraciones del panel izquierdo al lienzo.
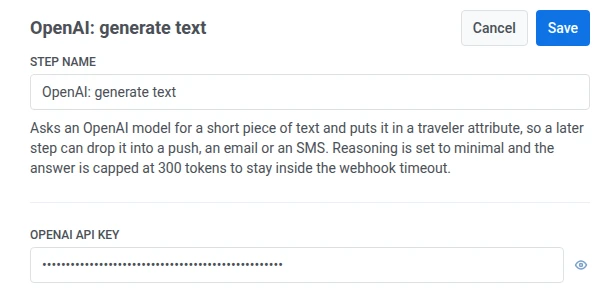
- Haz doble clic en el punto e introduce un Nombre del paso.
- En Clave de API de OpenAI, introduce tu clave de API de OpenAI. Se almacena enmascarada, como una cabecera secreta de webhook.
-
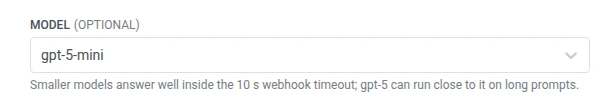
En Modelo, elige el modelo de OpenAI a utilizar. El valor predeterminado es gpt-5-mini.
- gpt-5-nano y gpt-5-mini: ambos responden bien dentro del tiempo de espera de 10 segundos del punto.
- gpt-5: puede acercarse al tiempo de espera con una indicación larga. Cuesta más por token que los modelos más pequeños.
Cada llamada factura a tu propia clave de OpenAI por cada viajero que llega a este paso.
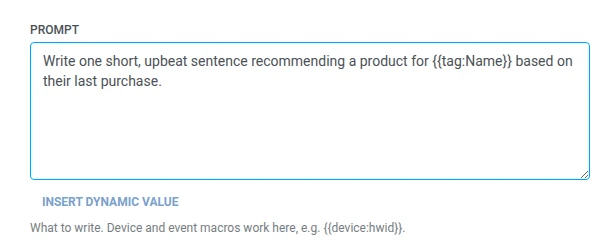
- En Prompt, escribe lo que quieres que el modelo genere. Acepta las mismas macros que cualquier cuerpo de Webhook, por ejemplo
{{device:hwid}}.
- Haz clic en Guardar.
El razonamiento se establece al mínimo y las respuestas están limitadas a unos 300 tokens (aproximadamente un párrafo corto) para mantener la solicitud dentro del tiempo de espera del Webhook. Pide algo así de corto. Una indicación más larga o detallada no obtiene más espacio para responder.
Respuesta
Anchor link toEl viajero continúa hacia el paso que conectes a continuación en el lienzo.
Atributos después de que se ejecute el paso
Anchor link to| Atributo | Lo que contiene |
|---|---|
llm_text | El texto generado |
llm_input_tokens | Recuento de tokens para la entrada de la solicitud |
llm_output_tokens | Recuento de tokens para la salida de la solicitud |
Cómo usar llm_text en pasos posteriores
Anchor link to- Insértalo en un push, correo electrónico o SMS: usa Contenido dinámico.
- Bifurca en base a él con División por condición: guárdalo primero en una Tag con Actualizar perfil de usuario, y luego divide en base a esa Tag.
Fallos y respuestas inesperadas
Anchor link toUna solicitud fallida elimina al viajero del recorrido. Consulta Errores y solicitudes fallidas.
Una respuesta que se recibe pero no es la que esperabas mantiene al viajero en el recorrido:
- Texto cortado en el límite de 300 tokens:
llm_textcontiene el texto truncado. - El modelo se negó a responder:
llm_textcontiene lo que sea que haya respondido en su lugar.
Escenario de ejemplo: Redactar una línea de correo electrónico de abandono de navegación con OpenAI
Anchor link toUn equipo quiere que un correo electrónico de abandono de navegación comience con una línea sobre el producto específico que un visitante miró, en lugar de un asunto genérico de “vuelve”.
- Añade un elemento de Entrada basada en un activador y configúralo para que se dispare con un evento
ProductViewedNoPurchase. - Añade OpenAI: generar texto justo después. En Prompt, escribe
Write one short sentence recommending {{tag:Last Viewed Product}} to a shopper who looked at it but didn't buy. - Añade un paso Enviar correo electrónico justo después, usando Contenido dinámico para insertar
llm_texten el cuerpo del correo electrónico.
Una vez que esto se ejecuta, cada visitante recibe una línea de apertura de correo electrónico sobre el producto exacto que vio, en lugar de una línea genérica para todo el segmento.