# Actualizar etiquetas mediante CSV
Cargue un archivo CSV para establecer los valores de varias etiquetas en muchos dispositivos a la vez, por ejemplo, para preparar datos para la segmentación.
Solo puede actualizar etiquetas que ya existen en su cuenta. La importación no crea etiquetas nuevas.
## 1. Preparar el CSV
Exporte un segmento y edítelo, o cree el archivo usted mismo.
### Exportar segmento
Vaya a [Segmentos](/es/product/audience-data-and-segmentation/segmentation), seleccione el segmento para el que desea establecer etiquetas y [exporte el segmento](/es/product/audience-data-and-segmentation/segmentation). El archivo contiene:
* HWID de los dispositivos que cumplen con ese segmento de filtro (en la primera columna del .csv)
* Tokens Push de los dispositivos del usuario (en la segunda columna)
* tipos de dispositivos (entero y humanizado)
* todas las etiquetas de su cuenta de Pushwoosh (en las columnas restantes)
Cambie los valores de las etiquetas o agregue los que falten en el archivo y, a continuación, guárdelo.
### Crear CSV
Para crear el archivo usted mismo, configure estas columnas:
* **Columna de identificador:** llámela `HWID` y rellénela con los ID de hardware de los dispositivos, o llámela `User ID` y rellénela con los ID de usuario.
* **Columnas de etiquetas:** nombre cada una exactamente como una etiqueta de su cuenta de Pushwoosh. Cada celda contiene el valor que se establecerá para ese dispositivo o usuario.
| HWID | Nombre | Edad | Alertas Push Habilitadas | Versión del SDK | Primera Instalación | Preferencias |
| ------------------------------------ | ---- | --- | ------------------- | ----------- | ------------------- | ---------------- |
| XXXX-XXXX-XXXX-XXXX-XXXXXXXXXXXX | Paul | 25 | false | 6.4.12.0 | 2023-06-27 12:00:00 | deporte, noticias |
| YYYY-YYYY-YYYY-YYYY-YYYYYYYYYYYY | Anne | 30 | true | 6.7.17.0 | 2025-11-14 16:00:00 | moda, viajes |
Representación de `import.csv` en formato de texto plano:
```txt
HWID,Name,Age,Push Alerts Enabled,SDK Version,First Install,Preferences
XXXX-XXXX-XXXX-XXXX-XXXXXXXXXXXX,Paul,25,false,6.4.12.0,2023-06-27 12:00:00,"sport, news"
YYYY-YYYY-YYYY-YYYY-YYYYYYYYYYYY,Anne,30,true,6.7.17.0,2025-11-14 16:00:00,"fashion, travel"
```
#### Valores de etiquetas de tipo lista
Una celda de una etiqueta de tipo lista (List Tag) admite dos formatos:
* **Lista separada por comas:** `sport, news`, como en el ejemplo anterior. Este formato es más fácil de producir en aplicaciones de hojas de cálculo. Los valores siempre se dividen por la coma.
* **Array JSON:** `["sport","news"]`. Úselo cuando un solo valor contenga una coma, por ejemplo, `["Sports, general","news"]`.
Dejar vacía la celda de una etiqueta de tipo lista mantiene sin cambios el valor existente del suscriptor para esa etiqueta. Para borrar el valor del suscriptor para una etiqueta de tipo lista, use un array JSON vacío (`[]`) en su lugar. Para etiquetas de otros tipos (String, Integer, Date), una celda vacía se importa tal cual y sobrescribe el valor existente del suscriptor.
## 2. Cargar CSV
1. Seleccione el proyecto. Los valores de las etiquetas se actualizan solo en este proyecto. Si un identificador no está registrado en este proyecto, su fila no recibe valores de etiquetas.
2. Vaya a **Importar CSV** → **Actualizar valores de etiquetas**.
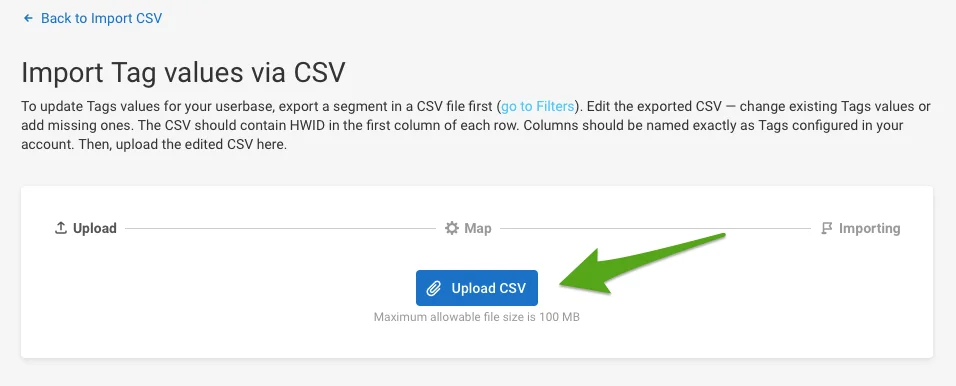
3. Haga clic en **Cargar CSV** y seleccione su archivo.
## 3. Elegir las etiquetas a actualizar
1. Elija el tipo de identificador que utiliza su CSV, **HWID** o **User ID**, y la columna que lo contiene. El tipo determina qué etiquetas se pueden actualizar:
* **HWID:** etiquetas específicas del dispositivo, como la versión del SDK.
* **User ID:** etiquetas específicas del usuario, cuyos valores pertenecen al perfil del usuario en lugar de a un dispositivo.
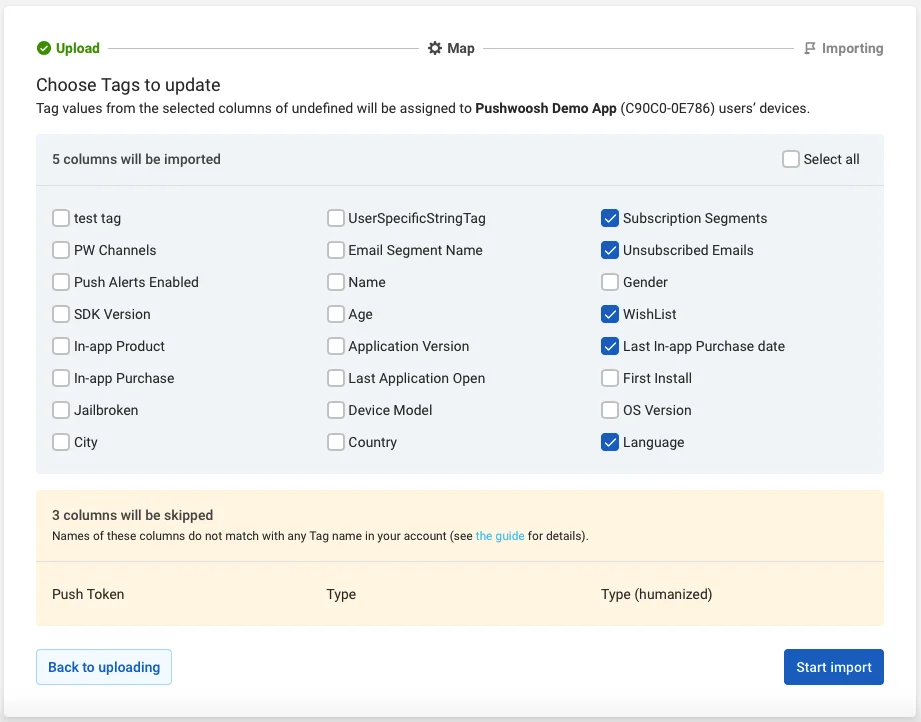
Pushwoosh muestra qué etiquetas se importarán y cuáles se omitirán para el tipo que eligió.
2. Seleccione las columnas para importar.
3. Haga clic en **Iniciar importación**.
## 4. Comprobar los resultados
El estado de la importación se actualiza en tiempo real. Los archivos grandes pueden tardar un tiempo, así que puede salir de la página y volver a consultarlo más tarde.
Cuando se completa la importación, el informe confirma que se actualizaron los valores de las etiquetas de las columnas seleccionadas. Revise sus recuentos:
* **Matched:** filas del CSV, no dispositivos, cuyo identificador encontró al menos un dispositivo.
* **Updated:** dispositivos, no filas. En una importación por User ID, una fila puede coincidir con varios dispositivos del usuario, por lo que este número puede ser mayor que **Matched**.
* **Updated users:** solo en una importación por User ID, el número de usuarios distintos con al menos un dispositivo actualizado. Dos filas del mismo usuario cuentan como una.
Una fila se omite por uno de estos dos motivos:
* **Ningún dispositivo coincide con el identificador.** Pushwoosh lo compara con el HWID, el User ID o el token push, independientemente del tipo de identificador que haya elegido en el paso 3.
* **La columna de identificador está vacía.** La fila nunca llega a la búsqueda de dispositivos.
Las filas coincidentes más las filas omitidas deben sumar el total de filas del archivo.
 3. Haga clic en **Cargar CSV** y seleccione su archivo.
 ## 3. Elegir las etiquetas a actualizar
1. Elija el tipo de identificador que utiliza su CSV, **HWID** o **User ID**, y la columna que lo contiene. El tipo determina qué etiquetas se pueden actualizar:
* **HWID:** etiquetas específicas del dispositivo, como la versión del SDK.
* **User ID:** etiquetas específicas del usuario, cuyos valores pertenecen al perfil del usuario en lugar de a un dispositivo.
Pushwoosh muestra qué etiquetas se importarán y cuáles se omitirán para el tipo que eligió.
2. Seleccione las columnas para importar.
3. Haga clic en **Iniciar importación**.
 ## 4. Comprobar los resultados
El estado de la importación se actualiza en tiempo real. Los archivos grandes pueden tardar un tiempo, así que puede salir de la página y volver a consultarlo más tarde.
Cuando se completa la importación, el informe confirma que se actualizaron los valores de las etiquetas de las columnas seleccionadas. Revise sus recuentos:
* **Matched:** filas del CSV, no dispositivos, cuyo identificador encontró al menos un dispositivo.
* **Updated:** dispositivos, no filas. En una importación por User ID, una fila puede coincidir con varios dispositivos del usuario, por lo que este número puede ser mayor que **Matched**.
* **Updated users:** solo en una importación por User ID, el número de usuarios distintos con al menos un dispositivo actualizado. Dos filas del mismo usuario cuentan como una.
Una fila se omite por uno de estos dos motivos:
* **Ningún dispositivo coincide con el identificador.** Pushwoosh lo compara con el HWID, el User ID o el token push, independientemente del tipo de identificador que haya elegido en el paso 3.
* **La columna de identificador está vacía.** La fila nunca llega a la búsqueda de dispositivos.
Las filas coincidentes más las filas omitidas deben sumar el total de filas del archivo.
